Baostock 获取中国 A 股数据教程
提示
这个文档源于我的课程中的教学资料,源文件为 Jupyter Notebook格式,发布在公众号主要是测试 VSCode 插件QMD2Any的功能。该插件指在实现在VSCode中将 Quarto / Markdown / R Markdown / Notebook 等格式文件一键导出公众号 & 知乎中。
教程目标
本教程目标是让你从零开始学会使用 Baostock 获取中国 A 股历史行情与部分财务数据,并完成基础分析。
学习完成后,你应能: 1. 理解 Baostock 的基本使用流程。 2. 获取 A 股股票列表与单只股票历史 K 线数据。 3. 使用 pandas 进行基础清洗与统计。 4. 画出收盘价走势图并保存数据到本地。
为什么选用 Baostock?
像 Akshare 这样的数据接口也可以获取 A 股数据,并且非常流行。但是Akshare 本质上是一个数据抓取工具,现在的趋势是各数据源反爬虫措施越来越严格,很容易出现接口失效的情况。而 Tushare Pro 需要注册并获取 token,基本上需要付费才能正常使用。相比之下,Baostock 是一个免费的 A 股数据接口,不依赖爬虫,数据源稳定,且无需注册即可免费使用,非常适合初学者。
一、安装baostock
# 如果你还没安装依赖,请先取消下一行注释后运行# !pip install baostock-i https://pypi.tuna.tsinghua.edu.cn/simpleimport sysprint("Python版本:", sys.version)Python版本: 3.12.12 | packaged by Anaconda, Inc. | (main, Oct 21 2025, 20:05:38) [MSC v.1929 64 bit (AMD64)]import baostock as bsimport pandas as pdimport matplotlib.pyplot as pltprint("库导入成功")二、登录 Baostock
使用 Baostock 前必须先登录。
lg = bs.login()print("login respond error_code:", lg.error_code)print("login respond error_msg:", lg.error_msg)login success!login respond error_code: 0login respond error_msg: success登录成功后,将通过具体的案例说明如何使用 Baostock 获取 A 股数据。
三、获取某日全部股票列表
先获取某个交易日的 A 股列表,方便后续选择股票代码。
说明: - sh 表示上交所,sz 表示深交所。 - 股票代码格式类似sh.600000、sz.000001。
rs = bs.query_all_stock(day="2026-7-24")data_list = []while (rs.error_code == "0") and rs.next(): data_list.append(rs.get_row_data())stock_df = pd.DataFrame(data_list, columns=rs.fields)print("股票数量:", len(stock_df))stock_df.head(10)四、获取单只股票历史日 K 线
下面以浦发银行 sh.600000 为例,获取 2023-01-01 到 2023-12-31 的日线数据。
字段解释(重点): - date: 交易日期 - open/high/low/close: 开高低收 - volume: 成交量 - amount: 成交额 - turn: 换手率 - pctChg: 涨跌幅(%) - peTTM: 滚动市盈率
什么是复权?
在股票历史数据中,分红、送股、配股会让价格出现“跳变”。 如果不处理,直接看长期走势会产生误解,所以常用“复权”来把历史价格放到可比口径。
- 前复权:以“当前价格体系”为基准,向前调整历史价格。常用于看长期技术走势。
- 后复权:以“历史价格体系”为基准,向后调整近期价格。常用于研究长期累计收益。
在 Baostock 的 query_history_k_data_plus 中,通常使用 adjustflag控制:
adjustflag="1"adjustflag="2"adjustflag="3"
当前代码使用的是adjustflag="2",因此拿到的是前复权口径,不是原始不复权价格。
query_history_k_data_plus 常用重要参数
函数原型(简化):query_history_k_data_plus(code, fields, start_date, end_date, frequency, adjustflag)
code- 示例:
"sh.600000"、"sz.000001"
fields- 示例:
"date,open,high,low,close,volume,amount,turn,pctChg,peTTM" - 作用:控制返回哪些列;字段越多,数据越全,处理也更重。
start_date- 作用:限定时间范围;若区间无交易日,结果可能为空。
frequency"d""w""m""5"、"15"、"30"、"60":分钟线(具体可用范围以接口实际支持为准)
adjustflag"1"- 作用:决定价格口径,直接影响开高低收、涨跌幅等分析结果。
实务中怎么选参数
- 做回测或还原当时交易价格:优先
adjustflag="3"(不复权)。 - 做技术形态观察、画长期趋势线:常用
adjustflag="2"(前复权)。 - 做长期收益复盘:可尝试
adjustflag="1"(后复权),并与不复权结果交叉验证。
建议:同一份分析报告中保持复权口径一致,并在图表标题或注释中明确写出“前复权 / 后复权 / 不复权”。
code = "sh.600000"fields = "date,open,high,low,close,volume,amount,turn,pctChg,peTTM"rs = bs.query_history_k_data_plus( code=code, fields=fields, start_date="2023-01-01", end_date="2023-12-31", frequency="d", adjustflag="2",)data_list = []while (rs.error_code == "0") and rs.next(): data_list.append(rs.get_row_data())k_df = pd.DataFrame(data_list, columns=rs.fields)k_df.head()<class 'pandas.core.frame.DataFrame'>RangeIndex: 242 entries, 0 to 241Data columns (total 10 columns): # Column Non-Null Count Dtype --- ------ -------------- ----- 0 date 242 non-null object 1 open 242 non-null object 2 high 242 non-null object 3 low 242 non-null object 4 close 242 non-null object 5 volume 242 non-null object 6 amount 242 non-null object 7 turn 242 non-null object 8 pctChg 242 non-null object 9 peTTM 242 non-null objectdtypes: object(10)memory usage: 19.0+ KB五、数据清洗与类型转换
刚下载的数据大多数是字符串类型,需要转换为数值和日期,才能做统计和画图。
k_df["date"] = pd.to_datetime(k_df["date"])num_cols = ["open","high","low","close","volume","amount","turn","pctChg","peTTM",]for c in num_cols: k_df[c] = pd.to_numeric(k_df[c], errors="coerce")print(k_df.dtypes)print("缺失值统计:")print(k_df.isna().sum())k_df.describe()date datetime64[ns]open float64high float64low float64close float64volume int64amount float64turn float64pctChg float64peTTM float64dtype: object缺失值统计:date 0open 0high 0low 0close 0volume 0amount 0turn 0pctChg 0peTTM 0dtype: int64 | | | | | | | | | | |
|---|
| | | | | | | | | | |
| 2023-07-04 08:43:38.181818112 | | | | | | | | | |
| | | | | | | | | | |
| | | | | | | | | | |
| | | | | | | | | | |
| | | | | | | | | | |
| | | | | | | | | | |
| | | | | | | | | | |
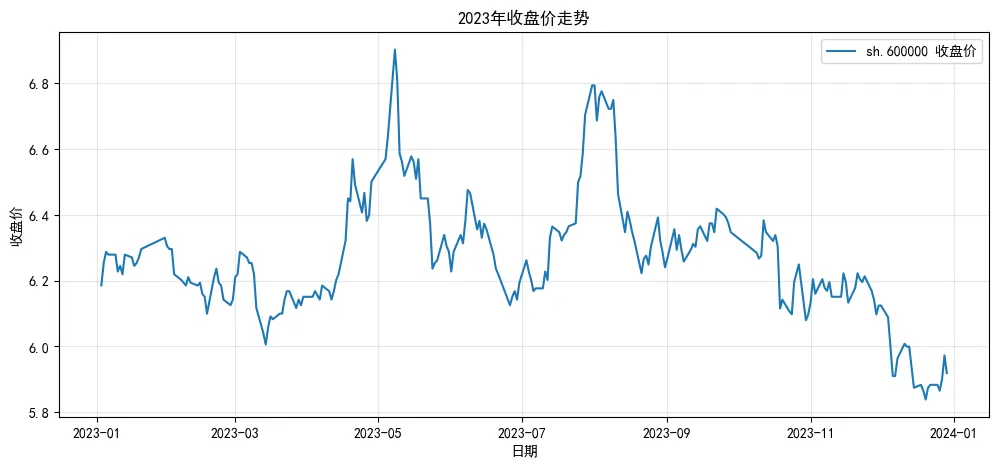
六、可视化:收盘价走势图
通过折线图观察股票价格随时间的变化趋势。
plt.rcParams["font.sans-serif"] = ["SimHei", "Microsoft YaHei", "Arial Unicode MS"]plt.rcParams["axes.unicode_minus"] = Falseplt.figure(figsize=(12, 5))plt.plot(k_df["date"], k_df["close"], label=f"{code} 收盘价")plt.title("2023年收盘价走势")plt.xlabel("日期")plt.ylabel("收盘价")plt.grid(alpha=0.3)plt.legend()plt.show()七、拓展:和上证指数做对比
在股市中我们经常比较个股和大盘表现。这里用上证指数 sh.000001做简单对比。
步骤: 1. 获取指数收盘价 2. 计算累计收益率 3. 画图比较
获取指数数据时要复权吗?
对于指数数据,通常不需要复权,因为指数本身已经考虑了成分股的分红、送股等因素。
index_rs = bs.query_history_k_data_plus( code="sh.000001", fields="date,close", start_date="2023-01-01", end_date="2023-12-31", frequency="d", adjustflag="3",)index_list = []while (index_rs.error_code == "0") and index_rs.next(): index_list.append(index_rs.get_row_data())index_df = pd.DataFrame(index_list, columns=index_rs.fields)index_df["date"] = pd.to_datetime(index_df["date"])index_df["close"] = pd.to_numeric(index_df["close"], errors="coerce")compare_df = pd.merge( k_df[["date", "close"]].rename(columns={"close": "stock_close"}), index_df[["date", "close"]].rename(columns={"close": "index_close"}), on="date", how="inner",)compare_df["stock_return"] = ( compare_df["stock_close"] / compare_df["stock_close"].iloc[0] - 1)compare_df["index_return"] = ( compare_df["index_close"] / compare_df["index_close"].iloc[0] - 1)plt.figure(figsize=(12, 5))plt.plot(compare_df["date"], compare_df["stock_return"], label="个股累计收益率")plt.plot(compare_df["date"], compare_df["index_return"], label="上证指数累计收益率")plt.title("个股与大盘累计收益率对比(2023)")plt.xlabel("日期")plt.ylabel("累计收益率")plt.grid(alpha=0.3)plt.legend()plt.show()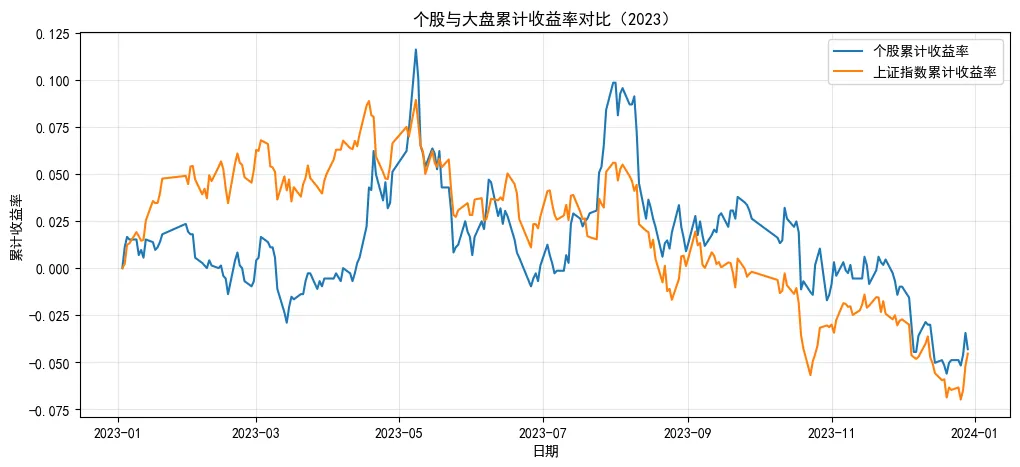
八、获取财务数据示例
Baostock 还支持部分财务数据。下面演示获取利润数据(示例:2023 年一季度)。
注意:财务数据接口字段较多,不同年份可能有缺失,属于正常现象。
profit_rs = bs.query_profit_data(code="sh.600000", year=2023, quarter=1)profit_list = []while (profit_rs.error_code == "0") and profit_rs.next(): profit_list.append(profit_rs.get_row_data())profit_df = pd.DataFrame(profit_list, columns=profit_rs.fields)profit_df九、保存数据到本地
数据分析项目通常需要把结果保存为 CSV,方便后续汇报、建模或共享。
import ossave_dir = "output"os.makedirs(save_dir, exist_ok=True)k_path = os.path.join(save_dir, "sh600000_kdata_2023.csv")c_path = os.path.join(save_dir, "compare_stock_index_2023.csv")p_path = os.path.join(save_dir, "sh600000_profit_2023q1.csv")k_df.to_csv(k_path, index=False, encoding="utf-8-sig")compare_df.to_csv(c_path, index=False, encoding="utf-8-sig")profit_df.to_csv(p_path, index=False, encoding="utf-8-sig")print("已保存文件:")print(k_path)print(c_path)print(p_path)已保存文件:output\sh600000_kdata_2023.csvoutput\compare_stock_index_2023.csvoutput\sh600000_profit_2023q1.csvlogout success!<baostock.data.resultset.ResultData at 0x1ca89f79ca0>总结
如果有使用过 Tushare Pro 或 Akshare 的同学,应该能明显感受到 Baostock 读取数据的时候相对而言更加繁琐。所以,后续如果要建一步使用,建议将自己常用的读取步骤封装成函数,或者写成一个类,方便后续调用。