当前位置:首页>行业>本周行业热点新闻 | 中国企业集群式亮相CES 2026;2026首批“国补”落地,补贴力度调整为15%;CES 2026半导体新趋势:AI驱动硬件全面革新

本周行业热点新闻 | 中国企业集群式亮相CES 2026;2026首批“国补”落地,补贴力度调整为15%;CES 2026半导体新趋势:AI驱动硬件全面革新

  • 2026-10-12 04:20:37
本周行业热点新闻 | 中国企业集群式亮相CES 2026;2026首批“国补”落地,补贴力度调整为15%;CES 2026半导体新趋势:AI驱动硬件全面革新

行业热点新闻

NEWS

本周要闻概览:

    • 定义AI边界,引领创新浪潮:中国企业集群式亮相CES 2026

    • 2026首批“国补”落地,2026国补补贴力度调整为15%

    • CES 2026揭示半导体新趋势:AI驱动硬件全面革新

    • 中国电信开源国产千亿MoE大模型TeleChat3!全栈自研,支持思考模式对标国际顶尖

    • DeepSeek发布新架构mHC,提升大模型训练稳定性

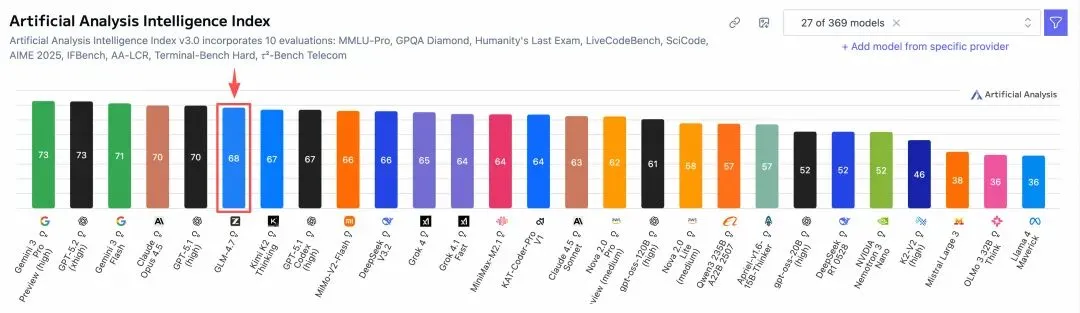
    • 中国自研GLM-4.7模型在Artificial Analysis全球开源榜单中夺冠,展现中国AI全球竞争力

    1、定义AI边界,引领创新浪潮:

    中国企业集群式亮相CES 2026

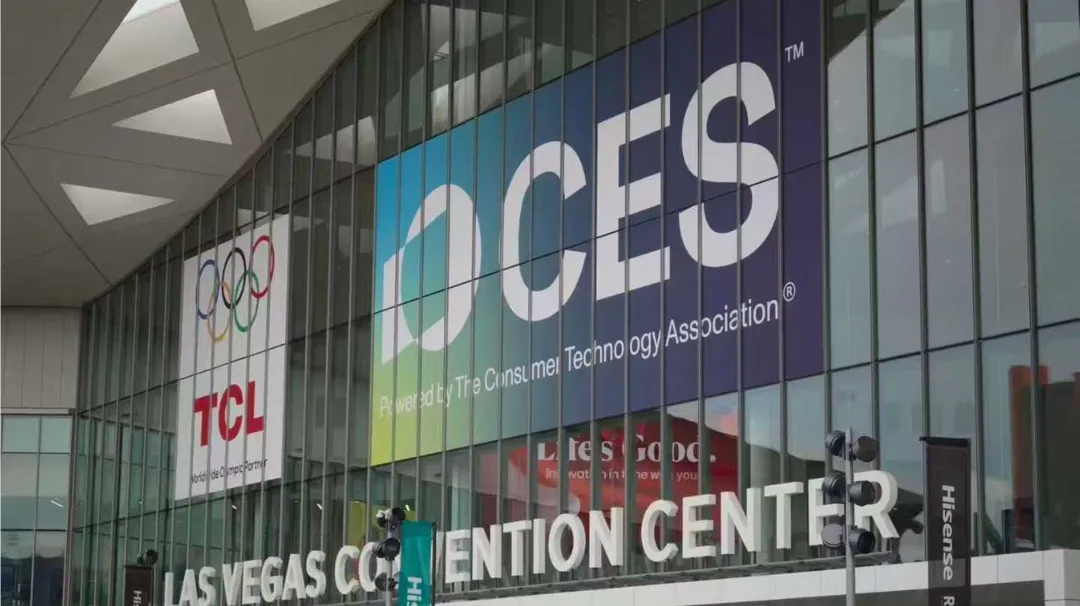
    2026年1月6日至9日,国际消费电子展(CES2026)以“定义AI的物理边界”为主题,于拉斯维加斯正式揭幕。这场全球科技年度盛会汇聚创新力量,展示未来趋势与科技新品,成为全球产业与媒体聚焦的“科技春晚”。本次CES展会中,中国科技力量正从“规模化参与”迈向“创新性定义”。在超过4000家参展商中,中国企业占比近四分之一,并在人形机器人、AI硬件、智能穿戴等多个关键赛道展现出集群式的创新实力与产品定义权。

    要闻观点:本届CES以“定义AI的物理边界”为主题,清晰揭示人工智能已成为全球科技发展的核心引擎。AI不再局限于云端算力与软件模型,正深度融入硬件载体,重新定义人机交互、移动出行与智能终端的形态与体验。在此背景下,中国科技企业的表现尤为亮眼。它们正从过去以供应链和市场规模为主的“规模化参与”,转向在前沿领域掌握“创新性定义权”。在人形机器人、AI硬件、智能穿戴等关键赛道形成集群式创新,展现出从技术整合到产品定义、从跟随迭代到引领标准的系统性能力跃迁。

    2、2026首批“国补”落地

    2026国补补贴力度调整为15%

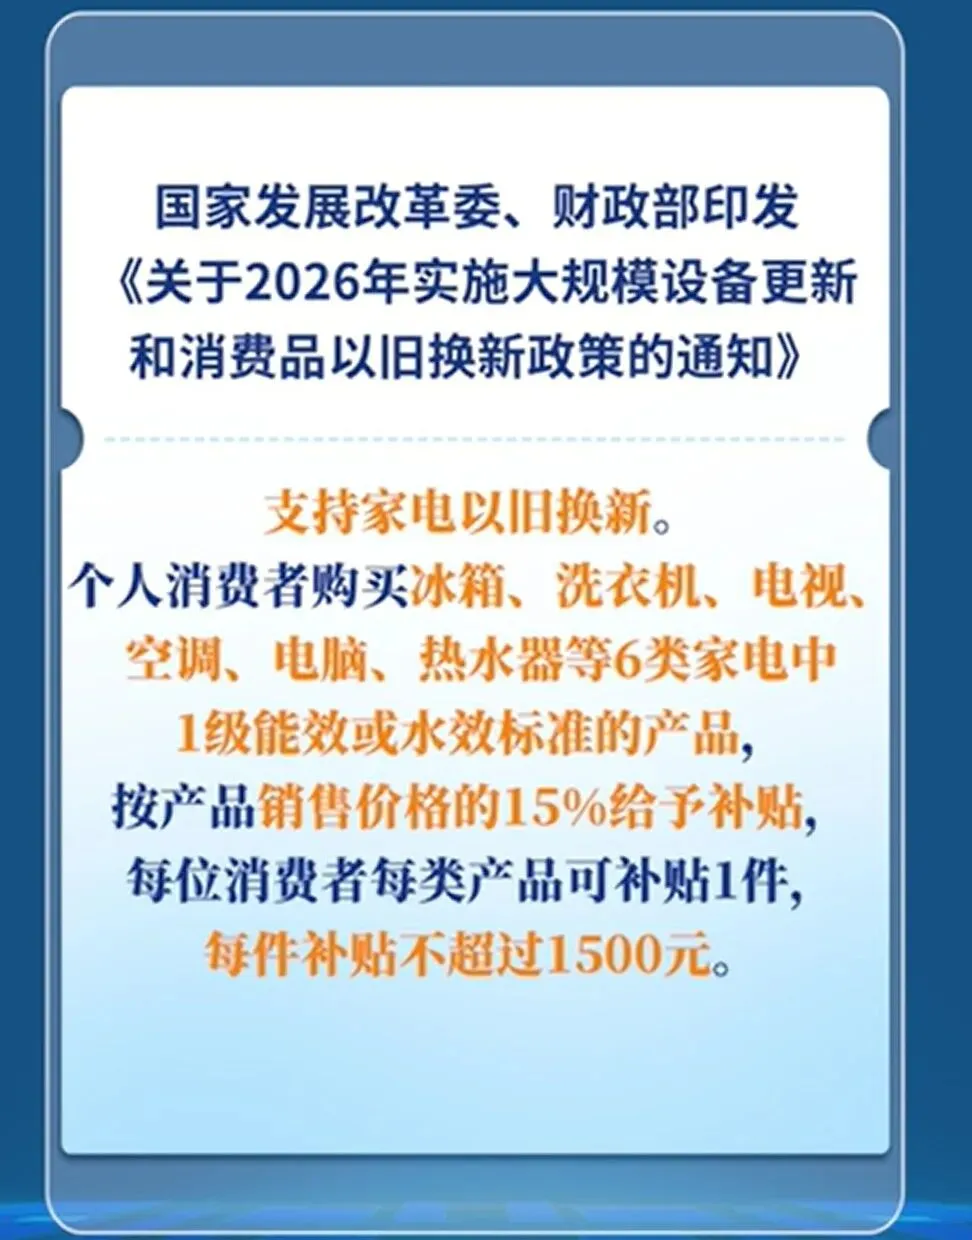
    近日,国家发展改革委、财政部发布《关于2026年实施大规模设备更新和消费品以旧换新政策的通知》(以下简称《通知》),明确今年继续实施消费品以旧换新政策,同时对补贴范围、具体品类及补贴力度作出调整。与2025年国补政策对比,今年国补范围总体保持稳定,呈现有增有减的特点。

    根据《通知》,今年国补主要涵盖四类,即汽车报废、汽车置换、家电和数码、智能产品。与2025年国补相比,取消了家装、电动自行车两大品类。2026年,数码和智能产品继续享受15%补贴、单件最高500元并新增智能眼镜品类,家电补贴仅限一级能效或水效产品、每件最高1500元。

    要闻观点:2026年国补政策在品类上“有增有减”,更显精准聚焦,但更关键的进步在于资金拨付机制的优化。过去“前多后少”的拨付方式导致季度末资金紧张,扰乱了市场节奏和消费预期。因此,今年强调“按季度、均衡、稳定”下达资金,是一处至关重要的治理思维转变。其目的在于构建一个可预期、可持续的政策环境,让消费者全年都能稳定享受红利,也让企业能据此进行稳健规划。这标志着政策重心从“短期刺激”转向“稳定预期”,通过建立市场信心来更持久地带动和引导消费。
    3、CES 2026揭示半导体新趋势:
    AI驱动硬件全面革新

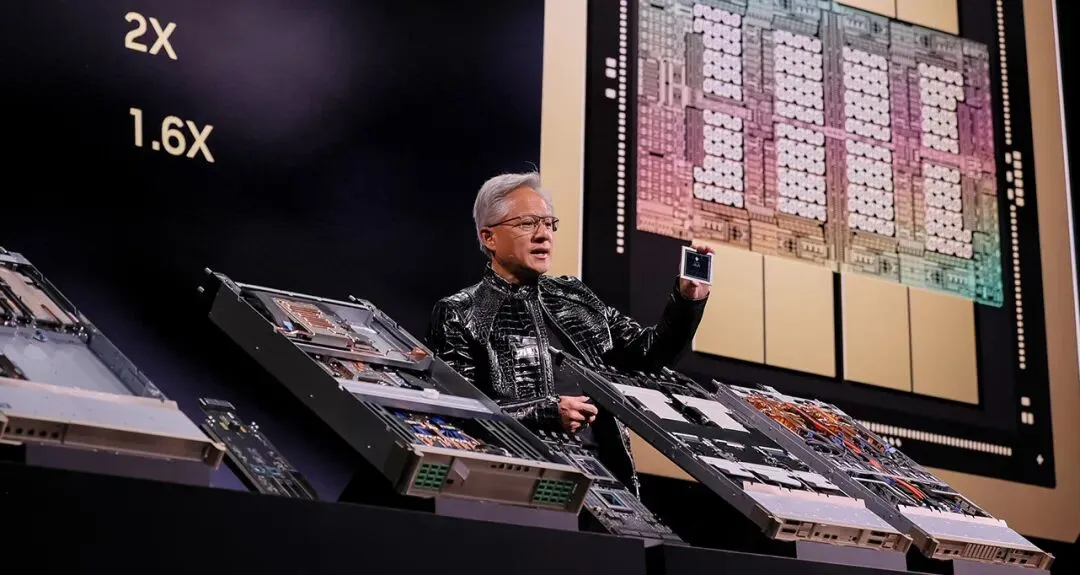
    CES 2026清晰表明,半导体产业正围绕AI落地与能效革新展开全面竞赛。处理器制程持续突破,算力大幅提升,体现行业从单纯追求性能转向兼顾效能与场景化应用。处理器领域,AMD、英伟达、英特尔和高通竞相推出新一代AI芯片,算力大幅提升的同时,更注重终端能效与本地化AI能力。存储器方面,SK海力士首发HBM4内存,三星、美光等厂商力推高速低功耗SSD,以应对AI带来的数据洪流。第三代半导体成为提升数据中心与电动汽车能效的关键技术,获博世、德州仪器等重点展示。此外,以黑芝麻智能为代表的中国厂商组团出海,在自动驾驶、具身智能等领域展示强劲竞争力。

    要闻观点:本届CES表明,半导体硬件创新正全力支撑AI从云端向边缘全面渗透。其核心逻辑在于:计算、存储、能源效率必须协同进化。处理器追求更高算力与更低功耗,存储器必须提供更大带宽与容量,而第三代半导体则是解决整体能耗瓶颈的基石。这标志着行业竞争已从单一性能指标,转向为AI规模化落地提供系统性、高效率的底层解决方案。中国厂商的活跃表现,则反映了全球半导体产业链与创新格局的多元化趋势。这场硬件革命,将成为AI真正融入千行百业的核心驱动力。

    4、中国电信开源国产

    千亿MoE大模型TeleChat3!

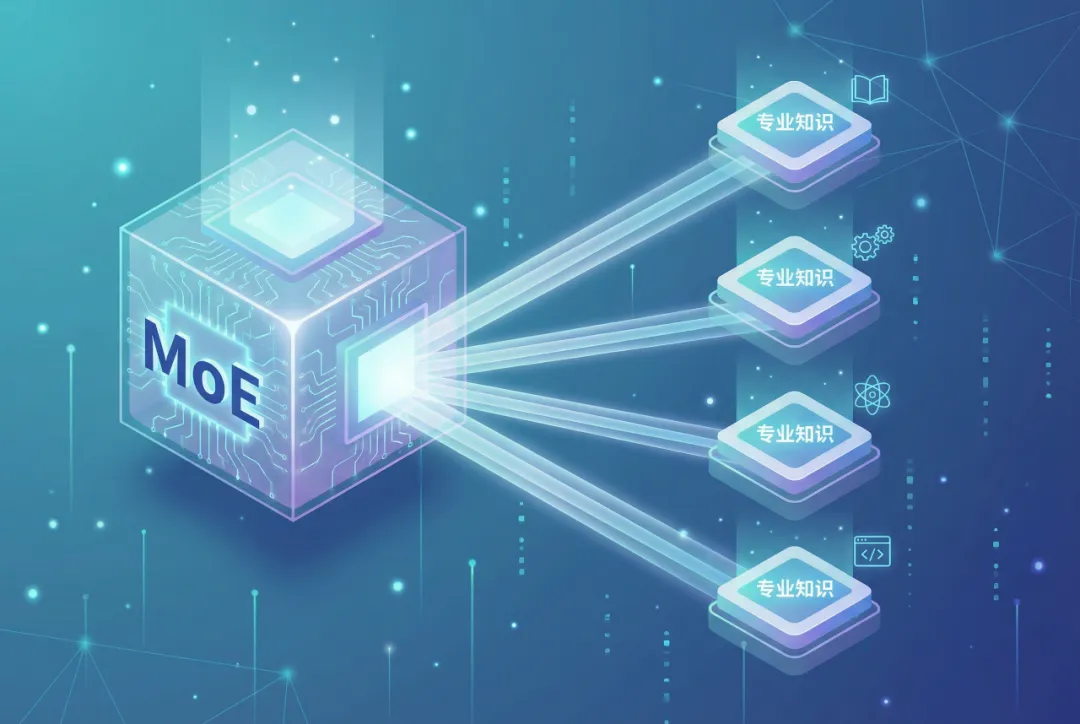
    中国电信人工智能研究院正式开源星辰语义大模型TeleChat3系列,包含国内首个基于全国产算力训练的千亿参数细粒度MoE模型,支持思考模式,在多项评测中达到国际顶尖水平,是国产大模型在技术自主与性能突破上的重要里程碑。该模型采用全栈自研架构,经过15万亿tokens的大规模训练,在多个基准测试中展现出与国际顶尖模型相媲美的性能。TeleChat3创新性地支持思考模式,能够模拟人类的推理过程,在复杂问题求解和决策支持场景中表现突出。其MoE架构通过动态激活专家网络,在保持高性能的同时显著降低计算能耗,为商业化部署提供了有力支撑。

    要闻观点:国产大模型TeleChat3通过技术创新与开源战略,正推动中国AI产业进入“能力对标”与“安全可控”并重的发展新阶段。其核心突破在于引入Thinking模式,将AI的推理过程显性化、可追溯,这不仅是技术能力的提升,更是构建可信AI、满足关键领域应用安全刚需的关键一步。这一举措表明,中国AI产业的竞争焦点正从单纯追求参数规模,转向构建以自主算力为底座、以安全可控为核心、以产业融合为目标的完整竞争力。

    5、DeepSeek发布新架构mHC

    提升大模型训练稳定性

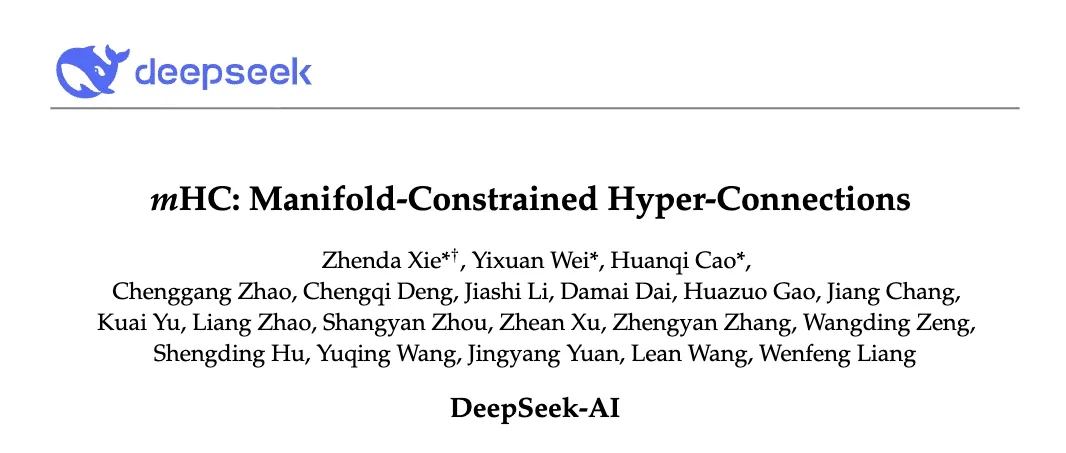
    近日,DeepSeek团队发布论文,提出一种名为“流形约束超连接”(mHC)的新结构,用于改进大语言模型的训练稳定性。该方法在不牺牲性能的前提下,有效缓解传统复杂连接结构带来的训练波动和梯度异常问题。测试显示,mHC在多个任务中表现优于基线模型,训练过程更平稳,仅带来少量额外计算开销,具备良好的可扩展性与应用前景。

    要闻观点:mHC架构的突破性意义,不在于改变Transformer范式,而在于首次将复杂系统的“受控涌现”思想工程化。它通过数学流形对神经网络内部的超连接进行主动约束,像为信息洪流预设“交通规则”,从而在保障训练稳定性的前提下,激发出更强大的模型性能。这标志着顶级AI研发已进入新阶段:从一味堆叠参数和数据,转向对系统内在动力学的精细设计与调控。虽然该技术会略微增加对高端显存带宽的需求,并未带来“算力通缩”,但它大幅提升了训练的确定性和效率,其价值远高于硬件成本的微增。

    6、中国自研GLM-4.7模型在

    Artificial Analysis全球开源榜单中夺冠

    大模型评测机构“人工智能分析网”公布的最新一期“AA智能指数”榜单中,中国自研的GLM-4.7模型以68分的综合成绩,荣登开源模型与国产模型双料榜首、全球第六。GLM-4.7模型由北京智谱华章科技股份有限公司研发,其成功不仅体现在榜单排名上,更在于其技术上的实质性突破。新模型面向编程(Coding)场景,重点强化了编码能力、长程任务规划与工具协同能力。该模型的发布立刻获得了全球开发社区的积极响应,包括Vercel、Kilo Code在内的多家国际主流AI平台第一时间宣布接入。

    要闻观点:中国自研大模型GLM-4.7在全球权威评测中登顶开源榜首,标志着我国人工智能技术已跻身全球第一梯队。行业分析认为,以GLM-4.7为代表的系列突破,是中国人工智能产业过去一年持续创新的结果。中国大模型企业正通过持续的开源策略和在垂直场景的应用优势,在全球AI治理与竞争格局中赢得更大的影响力与话语权。

    最新文章

    随机文章